
Abordar problemas de Redis para mejorar estabilidad y velocidad

A veces, las cosas salen mal en Transloadit. Cuando eso ocurre, queremos ser transparentes al respecto y asumir nuestros errores. Por eso, quiero dar a conocer un problema que afectó a 81 de nuestros clientes la semana pasada.
A principios de la semana pasada, llegaron reportes de un aumento de errores
WORKER_JOB_ERROR. Esto nos indica que hay un problema de comunicación entre nuestros
Uploaders (las máquinas que reciben los archivos y orquestan las Assemblies) y nuestros Drones (las máquinas que ejecutan las tareas de
encoding).
Compartimos el problema en Twitter y transloaditstatus.com, y comenzamos a investigar.
Como autores del módulo retry, hemos implementado reintentos para muchas cosas en Transloadit. Esto también significa que casi todas las Assemblies se pueden reejecutar sin pérdida de datos. Sin embargo, en algunos casos las Assemblies no se pudieron reejecutar y, en muchos otros, simplemente fueron mucho más lentas, debido a los reintentos con retardos exponenciales que se activaban cuando había errores.
Tras revisar nuestros logs y depurar el código, parecía que estábamos perdiendo Jobs encolados en el clúster regional de Redis de us-east, así como heartbeats entre los Uploaders y Drones ya mencionados. Monitorear los heartbeats nos permite entregar un Job a un Drone distinto si el Drone original deja de emitirlos.
De inmediato aplicamos un parche temporal volviendo a agregar los mensajes que se perdían y relajando el monitoreo de heartbeats. Sin embargo, ese enfoque solo combatía los síntomas, en lugar de atacar la raíz del problema. Además, tuvo el costo de aumentar el tiempo de ejecución de cada Assembly. En otras palabras, teníamos que hacer más.
El plan de acción
Así que el equipo se reunió y varios de sus miembros tomaron caminos distintos para determinar la causa raíz del problema. Más concretamente:
- Verificamos si nos habíamos perdido algún parche crítico de Redis y actualizamos a la última versión estable.
- Hicimos una auditoría completa del código de nuestra biblioteca del lado del cliente y evaluamos la forma en que la usamos.
- Mejoramos nuestro monitoreo, métricas, alertas y entradas de log. Ya monitoreamos numerosas métricas, pero solo podemos configurar alertas sensatas para una cantidad limitada. Es posible que nuestra selección se haya quedado corta.
Cuando el equipo volvió a reunirse para compartir sus hallazgos, se habían encontrado problemas en varios frentes:
- No estábamos ejecutando la última versión de Redis, en la que se habían corregido varios bugs
alarmantes, algunos de ellos marcados con
[FIX] Fixed data loss. - El equipo no encontró problemas en la versión reciente de la biblioteca del lado del cliente que estábamos usando. ✅
- Habíamos estado registrando la cantidad de comandos de Redis, las conexiones y el uso de swap, entre otros, pero no el ancho de banda. Estábamos funcionando con un clúster de 3 nodos en EE. UU., y parecía poco probable que llegáramos a saturar todas sus tarjetas de red. Sin embargo, al mirar de cerca, resultó que era exactamente lo que estábamos haciendo.
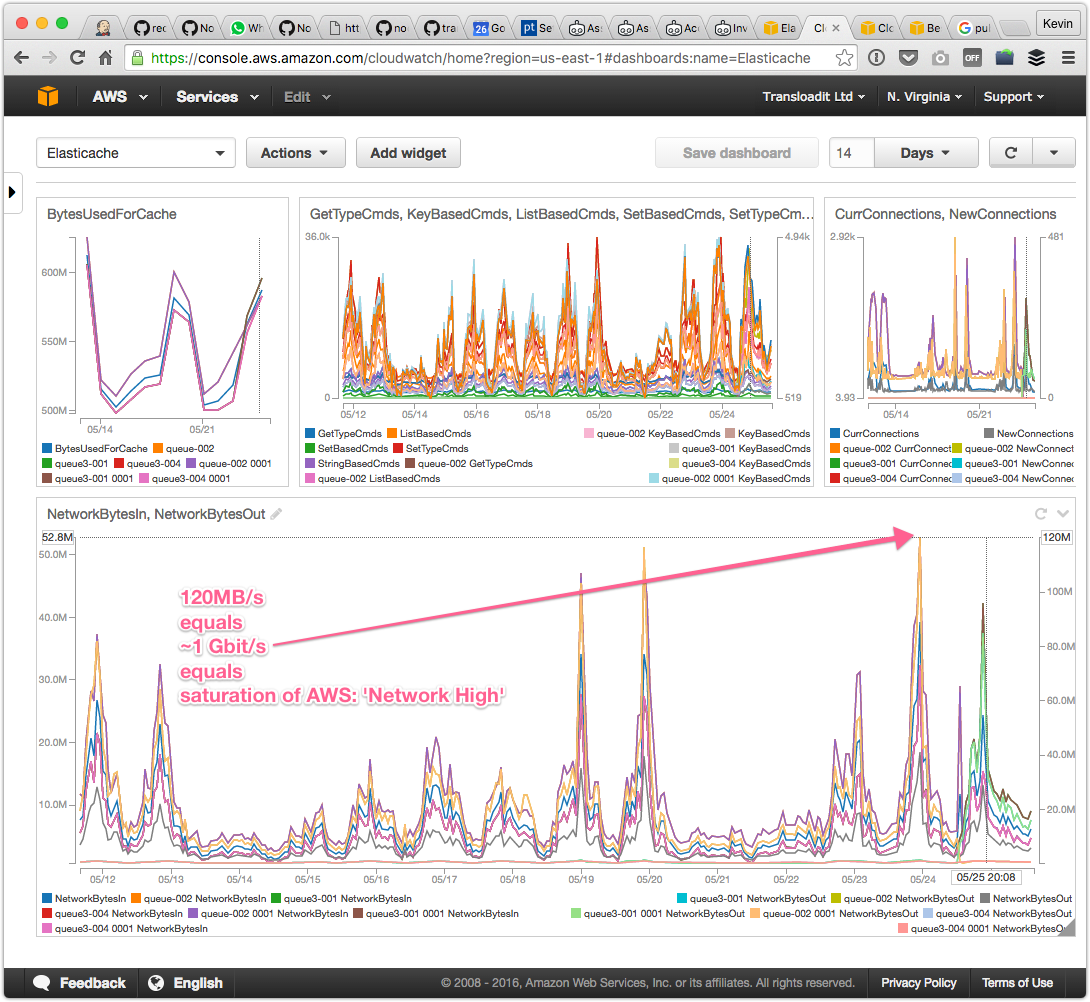
En cuanto se hizo evidente que el ancho de banda nos estaba limitando, duplicamos el tamaño de nuestro clúster. Esto debería repartir la carga de trabajo entre seis nodos de Redis, con un rendimiento total de lectura de ~6Gbit/s. Estábamos convencidos de que eso sin duda sería suficiente.
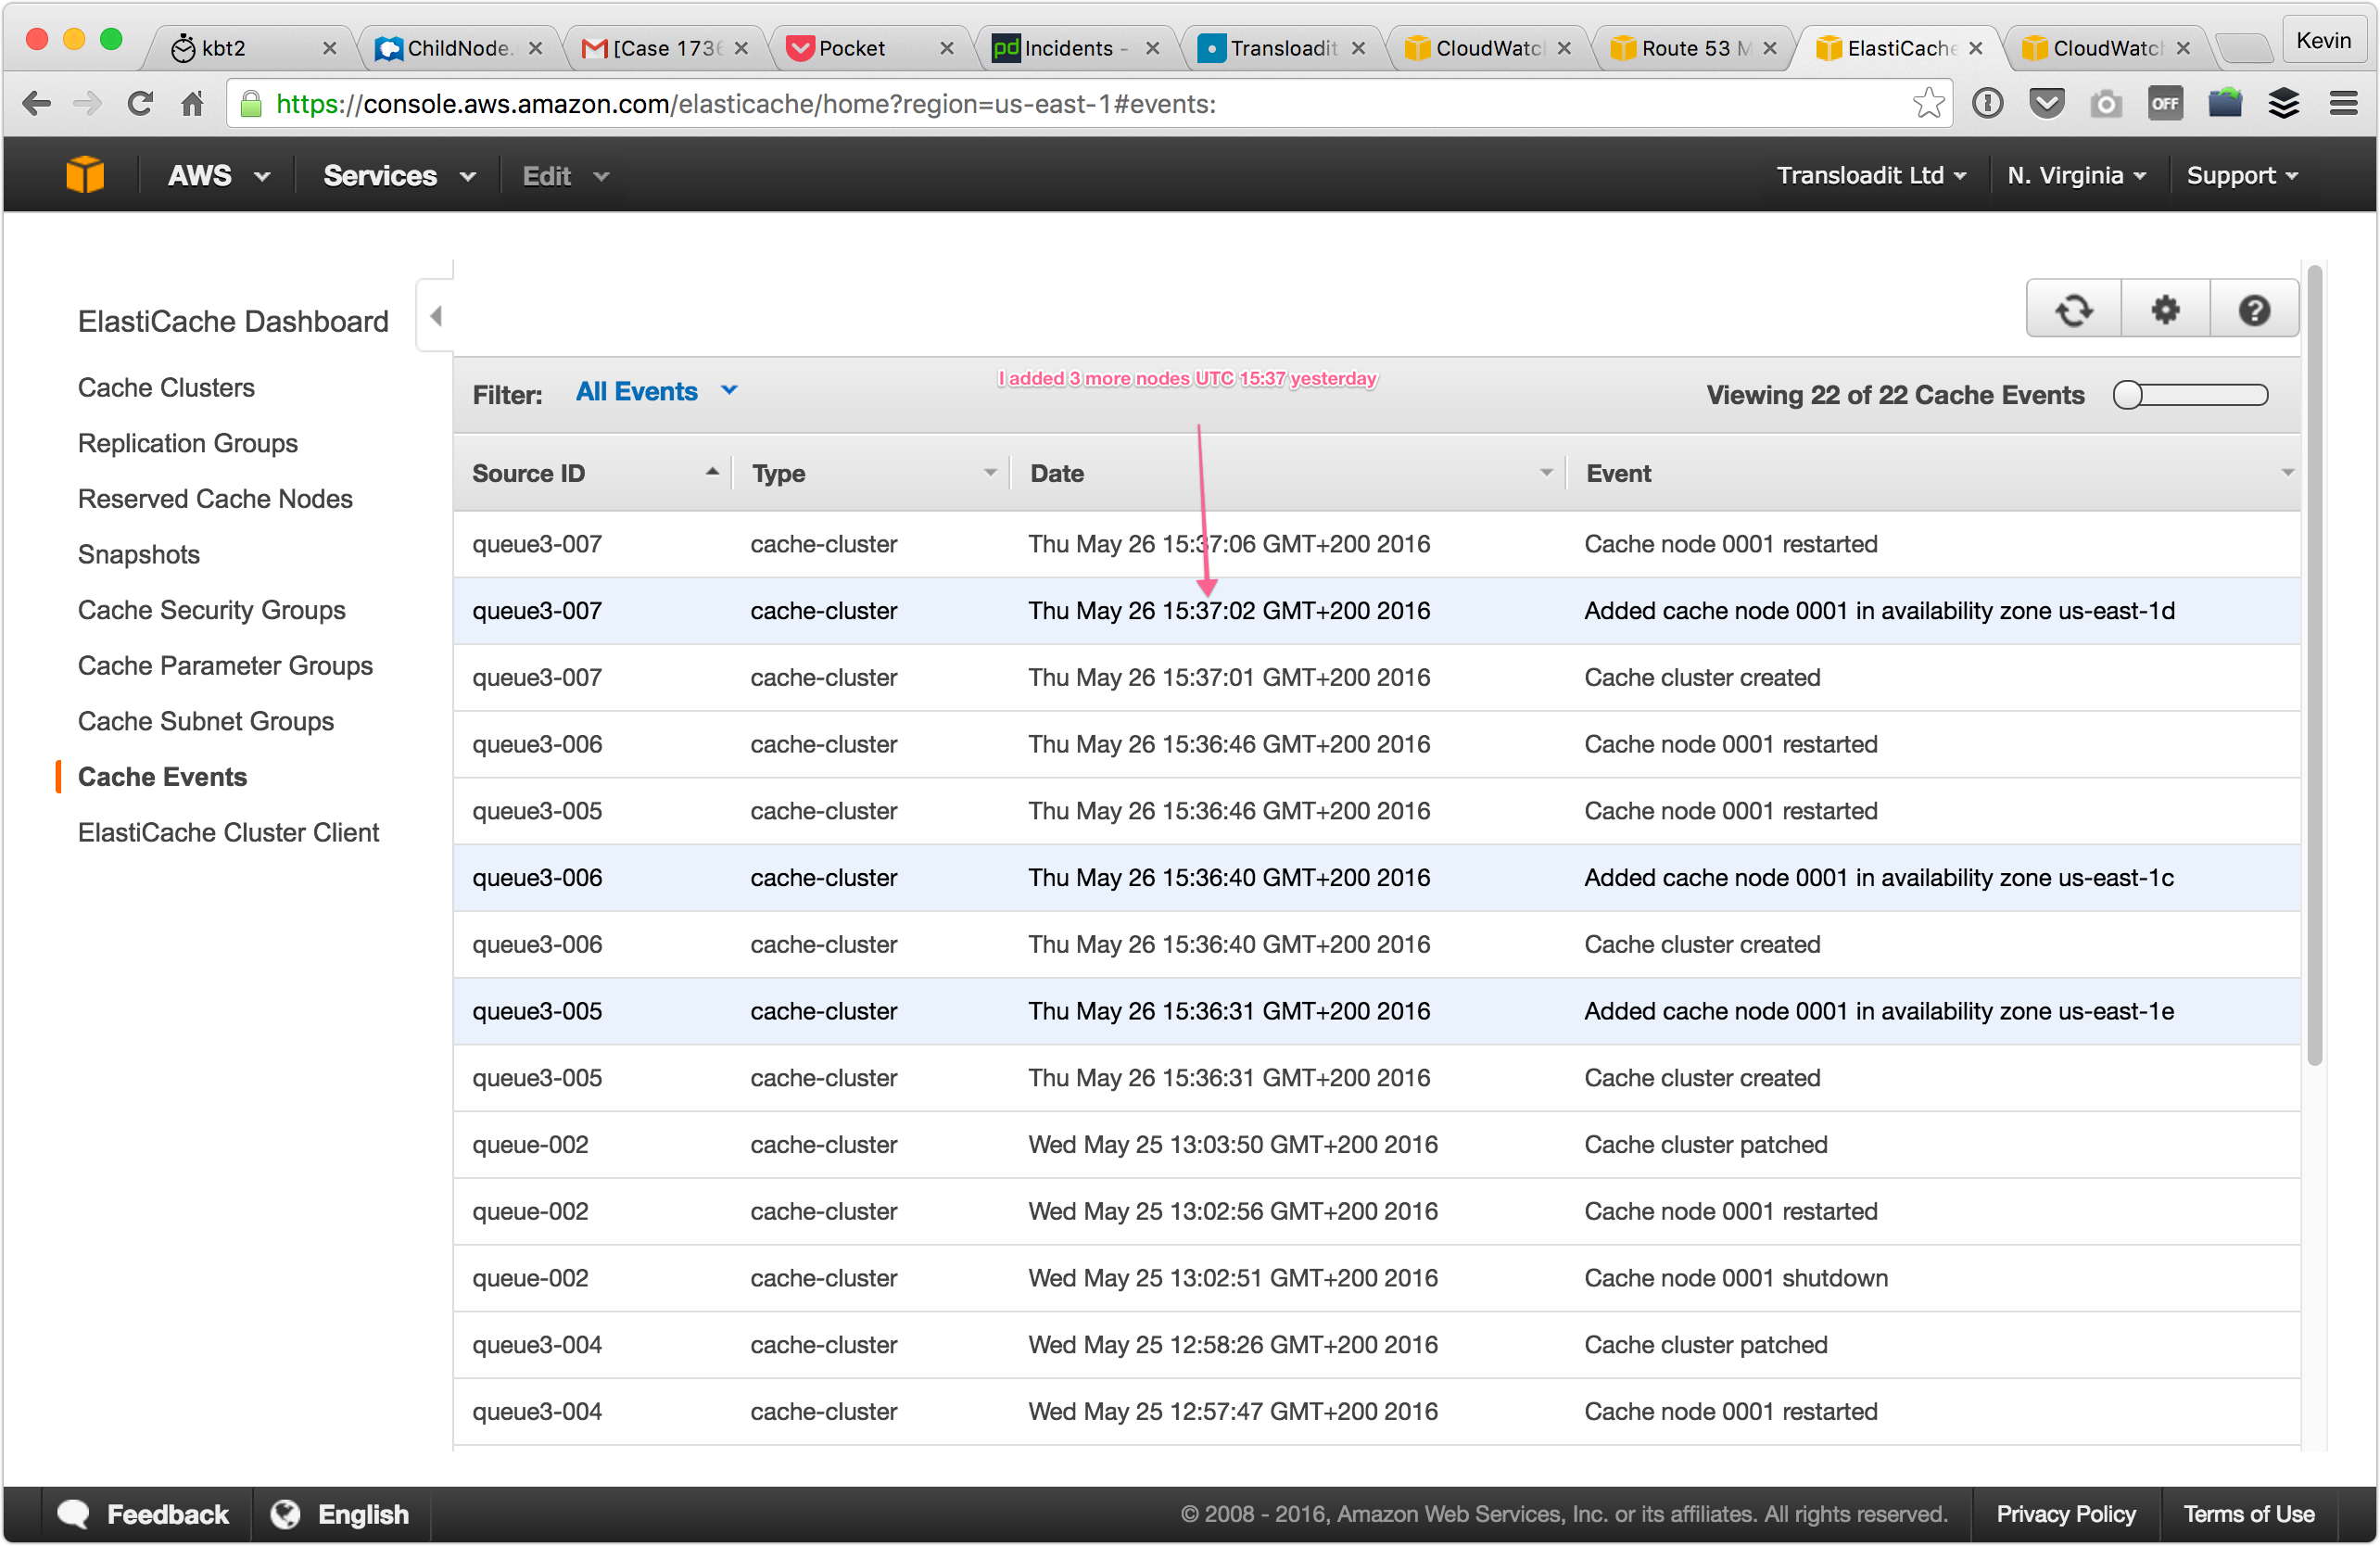
Después de esto, notamos un aumento inmediato en el consumo de ancho de banda:
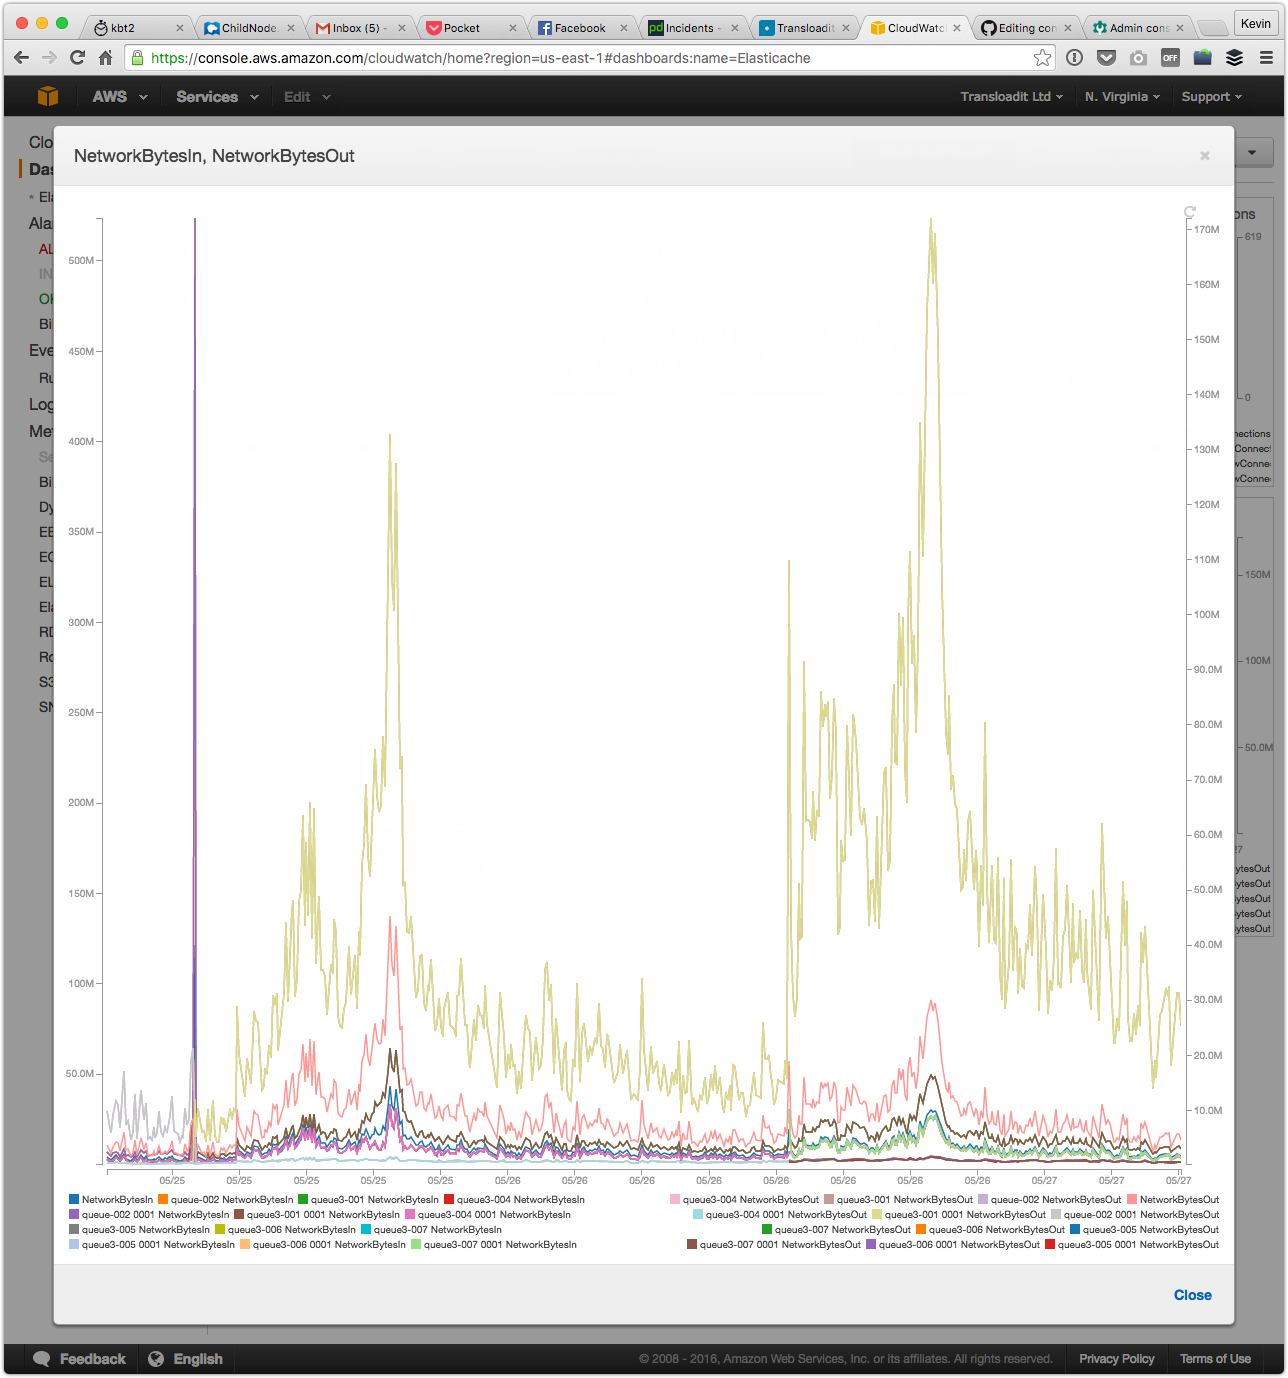
Sin embargo, el consumo alcanzaba rápidamente nuevos puntos de saturación y muchas Assemblies seguían lentas. Al principio pensamos que seguíamos subestimando el tamaño necesario de nuestro clúster. Las limitaciones de tres nodos de Redis nos habían frenado y, como seis nodos de Redis tampoco parecían suficientes, agregamos otros tres nodos de Redis para ver cómo afectaría eso al consumo de ancho de banda.
Para nuestra sorpresa, esto solo pareció empeorar las cosas. Al examinarlo más de cerca, notamos que el grueso del tráfico saliente lo generaba el líder del clúster. Con ~4Gbit/s, ahora emitía mucho más tráfico del que Amazon anuncia como posible (lo que podría ser material interesante para un futuro artículo del blog), mientras que el tráfico en los demás nodos de Redis se mantenía dentro de los límites.
Esto era extraño, porque el tráfico saliente (las lecturas) debería repartirse por todo el clúster. ¿Por qué el líder generaba tanto? Aparte de manejar las escrituras y Pub/Sub, solo debería emitir aproximadamente una novena parte del tráfico saliente total.
Menos es más
Solo entonces caímos en cuenta: la replicación. Cada escritura iba al líder y, en lugar de sincronizar los bits escritos con dos nodos de Redis, ahora tenía que sincronizar esos datos con ocho nodos de Redis. Como Redis no cuenta con un protocolo sofisticado como gossip, todo lo que enviaban nuestros Drones ahora debía copiarse a ocho nodos en lugar de dos (lo que ya era problemático). Eso es cuatro veces más trabajo y tráfico saliente para este único líder de Redis.
Para hacerlo un poco más doloroso, nuestros datos son intensivos en escritura y muy volátiles. Solo son útiles durante un breve instante. Así que, una vez copiados, también había que borrarlos poco después.
Como podemos volver a agregar los datos faltantes, nos replanteamos si la replicación, que parecía una buena idea, era realmente un requisito.
Lo ideal sería no tener nada de tráfico de replicación y hacer failover a un nodo de Redis vacío. Sin embargo, con AWS Elasticache la replicación es obligatoria para el failover automático. Con este nuevo conocimiento, redujimos la cantidad de réplicas de lectura a una. Nuestros logs mostraron de inmediato una caída tanto en el tráfico como en las tasas de fallos, y las Assemblies también empezaron a acelerarse de nuevo.
Respirar
Tras encontrar por fin la causa raíz, pudimos respirar de nuevo y empezamos a preguntarnos cómo había podido pasar esto. Resultaba algo desconcertante, porque no encontrábamos ningún cambio en nuestro código o infraestructura que explicara la repentina saturación de nuestra capacidad de Redis.
Sin embargo, sí notamos dos cambios en el entorno:
- Un fuerte aumento del tráfico HLS. HLS divide los videos grandes en muchos fragmentos pequeños, lo que permite a los usuarios móviles descargar el siguiente fragmento de video con la calidad óptima para su conexión actual (degradando todo de forma elegante hasta dejar solo el audio cuando la conexión se vuelve muy mala). Esto puede llevar fácilmente a que se transfieran mil veces más metadatos por cada video.
- Podemos tener más Drones en línea para procesar el mismo volumen en menos tiempo. Esto lleva inherentemente a que los nodos centrales estén más ocupados
Fue la combinación de estos dos cambios lo que expuso este cuello de botella en nuestra infraestructura. Después tomamos la decisión equivocada de aumentar la cantidad de nodos de Redis para aliviar el problema, pero resultó que tener más máquinas en realidad afectaba el rendimiento. Para poder manejar más tráfico, teníamos que usar menos nodos.
Mirando hacia adelante
Como resultado de nuestra amplia investigación, ahora se han actualizado todos los componentes de software mencionados, así que ya no somos susceptibles a bugs conocidos que puedan provocar la pérdida de heartbeats o de datos, más allá de los problemas de ancho de banda que encontramos. También configuramos logging y alarmas adicionales por si volvemos a acercarnos a niveles de saturación.
El tráfico entre los nodos de Redis y nuestros Drones y Uploaders era legítimo y, por lo tanto, tendremos que empezar a buscar formas de descentralizar ese tráfico. La reducción del tráfico de replicación quizá nos dio algo de tiempo, pero queremos poder sostener un crecimiento que no es posible con un único nodo de Redis aceptando las escrituras. Incluso si escalamos verticalmente (con un solo nodo de Redis más grande) y sin replicación, eso deja un nuevo cuello de botella incómodamente cerca.
Pensamos en tener réplicas de lectura de réplicas de lectura, para repartir el tráfico de replicación, pero, si nuestro crecimiento continúa, eso también nos dará solo unos meses más. Además, estar limitados por las escrituras y saber que estas deben permanecer en una sola máquina elimina por completo esta opción.
También pensamos en migrar a otro almacén de datos (distribuido) optimizado justo para este propósito, pero una migración de esa escala probablemente tomaría semanas, si no meses, en completarse. Es tiempo que simplemente no tenemos. Cambiar de almacén de datos en plena operación ya es bastante complicado, y más aún cuando vas con prisa.
El sharding parece nuestra mejor apuesta en este punto. El sharding te permite compartimentar los datos en distintos grupos lógicos y ejecutar cada grupo en hardware separado (o en el mismo, pero tú decides). Otras empresas suelen hacer sharding por cliente individual. Actualmente ya hacemos sharding por región y ahora tenemos planes de agregar sharding adicional por Uploader. El sharding por cliente parece menos ideal en nuestra configuración, porque un solo cliente con una importación grande podría, por sí solo, llevar Redis al límite. Sin embargo, ya escalamos los Uploaders con los picos de tráfico, así que iremos ganando gradualmente más capacidad de Redis a medida que llegue más tráfico. El tráfico se etiqueta con el nombre del Uploader, así que también será evidente qué nodo de Redis habrá que atender.
El trabajo en esto ya comenzó y planeamos lanzarlo esta semana. Mientras tanto, pusimos un límite al escalado de Drones en cada región. Esto significa que completar importaciones grandes por lotes podría tomar un poco más de lo que esperas, pero el sistema se mantendrá estable.
Lo sentimos
Entendemos que los tiempos de ejecución lentos pueden ser muy frustrantes, igual que tener que reejecutar manualmente las Assemblies que no lo hicieron de forma automática. Queremos ofrecer nuestras más sinceras disculpas, además de una semana de servicio gratuito a quienes se vieron muy afectados por esto. Por favor, escríbenos y lo compensaremos. Por supuesto, el reembolso de tu dinero probablemente no es lo que te importa. Lo que importa es un servicio confiable. Aun así, esperamos que ayude a aliviar un poco el dolor y que sirva para demostrar que nos tomamos muy en serio problemas como estos.