

Redis の問題解消による安定性と速度の向上

Transloadit でも、問題が起きることはあります。その際には、状況を透明に伝え、自分たちの過ちを認めたいと考えています。その方針に沿って、先週、81 のお客様に影響を及ぼした問題についてお伝えします。
先週初め、WORKER_JOB_ERROR エラーが増えているとの報告が寄せられました。これは、Uploader(ファイルを受け取り、Assemblyを統括するマシン)と、Drone(エンコードタスクを実行するマシン)の間で通信に問題があることを示しています。
Twitter と transloaditstatus.com で問題を共有し、調査を開始しました。
私たちは retry モジュールの開発者でもあり、Transloadit では多くの処理にリトライを実装しています。このため、ほぼすべての Assemblyはデータを失わずに再実行できます。しかし、一部のAssemblyは再実行できず、それ以外にも多くの処理で、エラー発生時に指数バックオフを伴うリトライが働き、処理が大幅に遅くなっていました。
ログを詳しく調べ、コードをデバッグしたところ、us-east リージョンの Redis クラスターでキューに入れたJobと、前述の Uploader と Drone の間のハートビートが失われているようでした。ハートビートを監視することで、元の Drone がハートビートを送信しなくなった場合に、別の Drone にJobを割り当てられます。
直ちに応急処置として、失われたメッセージを再追加し、ハートビート監視の条件を緩和しました。ただし、これは根本原因の解消ではなく、対症療法にすぎませんでした。さらに、Assemblyの実行時間が長くなるという代償もありました。つまり、さらなる対策が必要でした。
対応計画
そこでチームで集まり、メンバーがそれぞれ異なる観点から根本原因を調べることにしました。具体的には、次の対応を行いました。
- 重要な Redis パッチの適用漏れがないかを確認し、最新の安定版にアップグレードしました。
- クライアント側ライブラリのコードを全面的に監査し、その使い方を評価しました。
- 監視、メトリクス、アラート、ログの記録を強化しました。すでに多数のメトリクスを監視していますが、適切なアラートを設定できる対象には限りがあります。その選択が不十分だった可能性があります。
チームが再び集まって調査結果を共有すると、複数の問題点が見えてきました。
- 使用していた Redis は最新版ではありませんでした。最新版では、
[FIX] Fixed data lossと記されたものも含め、深刻なバグがいくつも修正されていました。 - 使用していたクライアント側ライブラリの比較的新しいバージョンには、問題は見つかりませんでした。✅
- Redis のコマンド数、接続数、スワップ使用量などは追跡していましたが、帯域幅は対象外でした。米国で 3 ノードのクラスターを稼働させており、そのすべてのネットワークカードが飽和することは考えにくいと思っていました。しかし、詳しく調べると、まさにそれが起きていたのです。
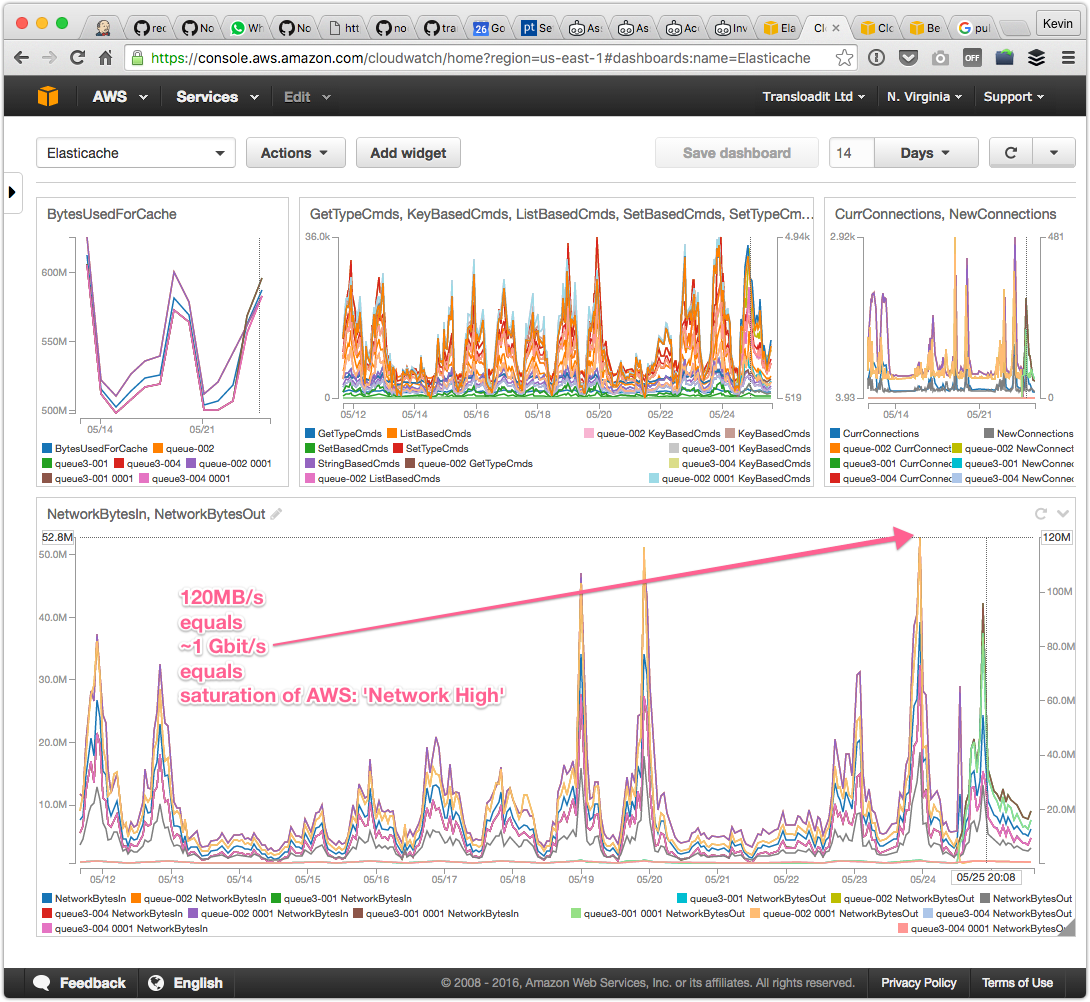
帯域幅による制限だと分かると、すぐにクラスターの規模を倍にしました。これで負荷が 6 台の Redis ノードに分散され、読み取りスループットの合計は約 6Gbit/s になるはずでした。これなら確実に足りると考えていました。
その直後、帯域幅の使用量が増えたことを確認しました。
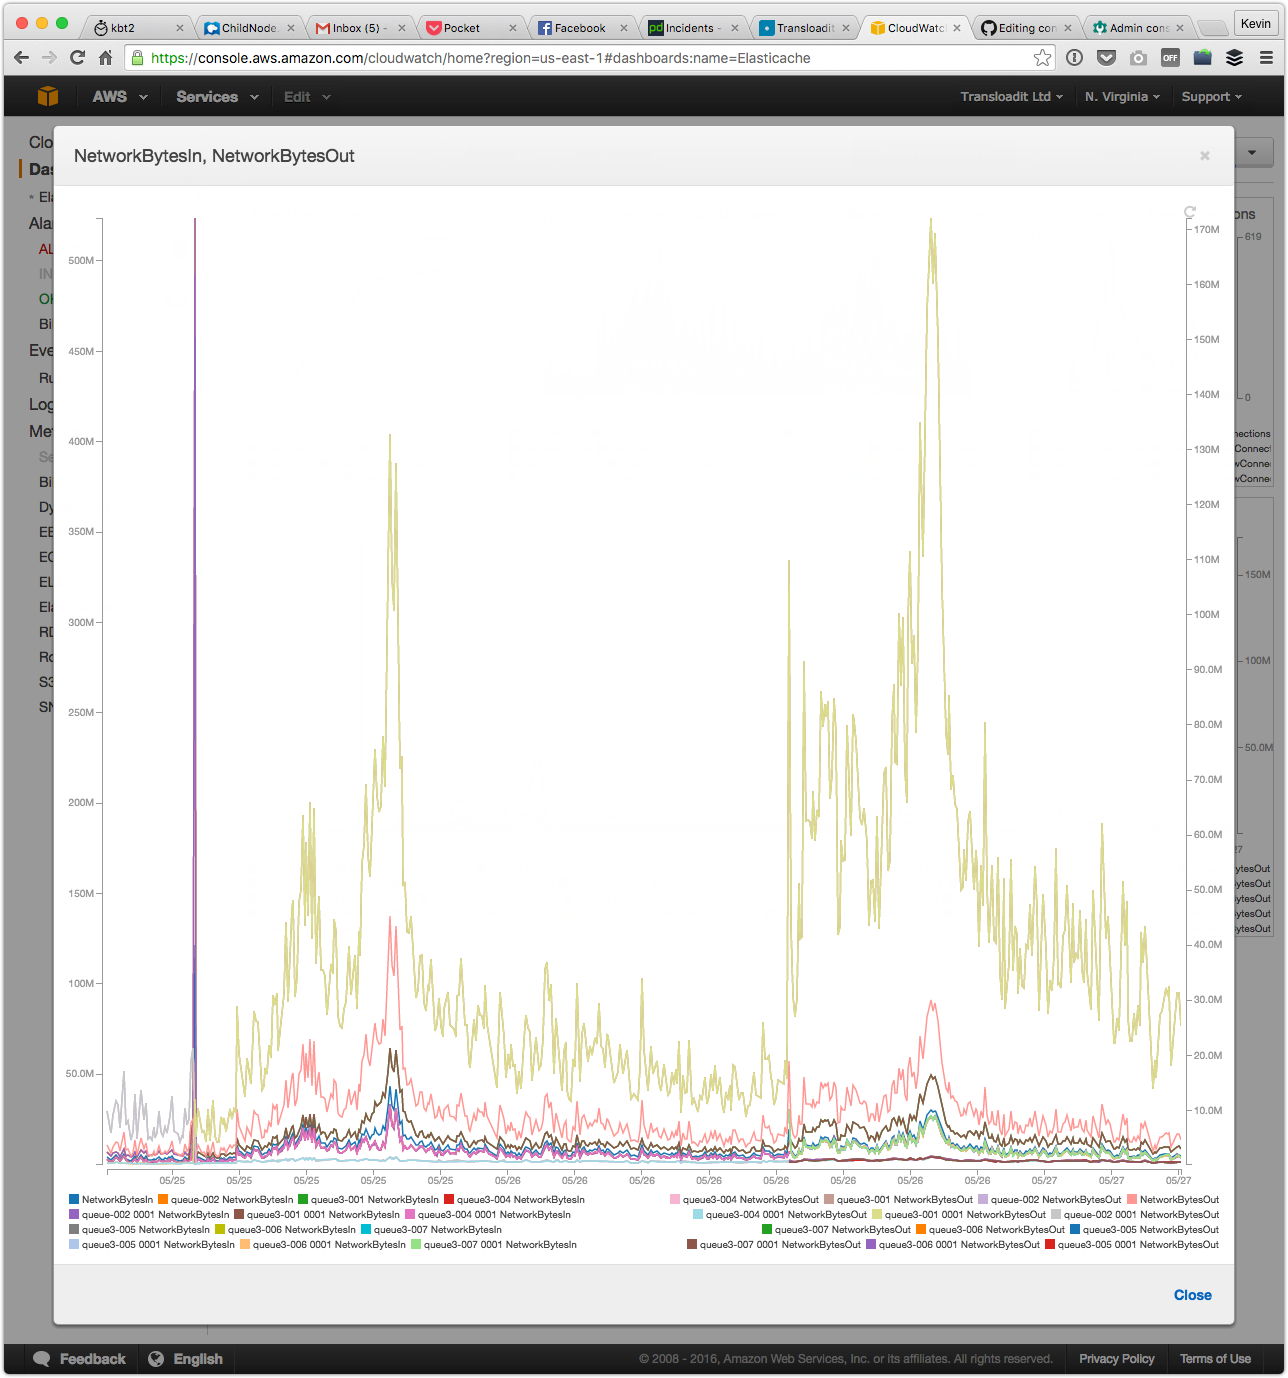
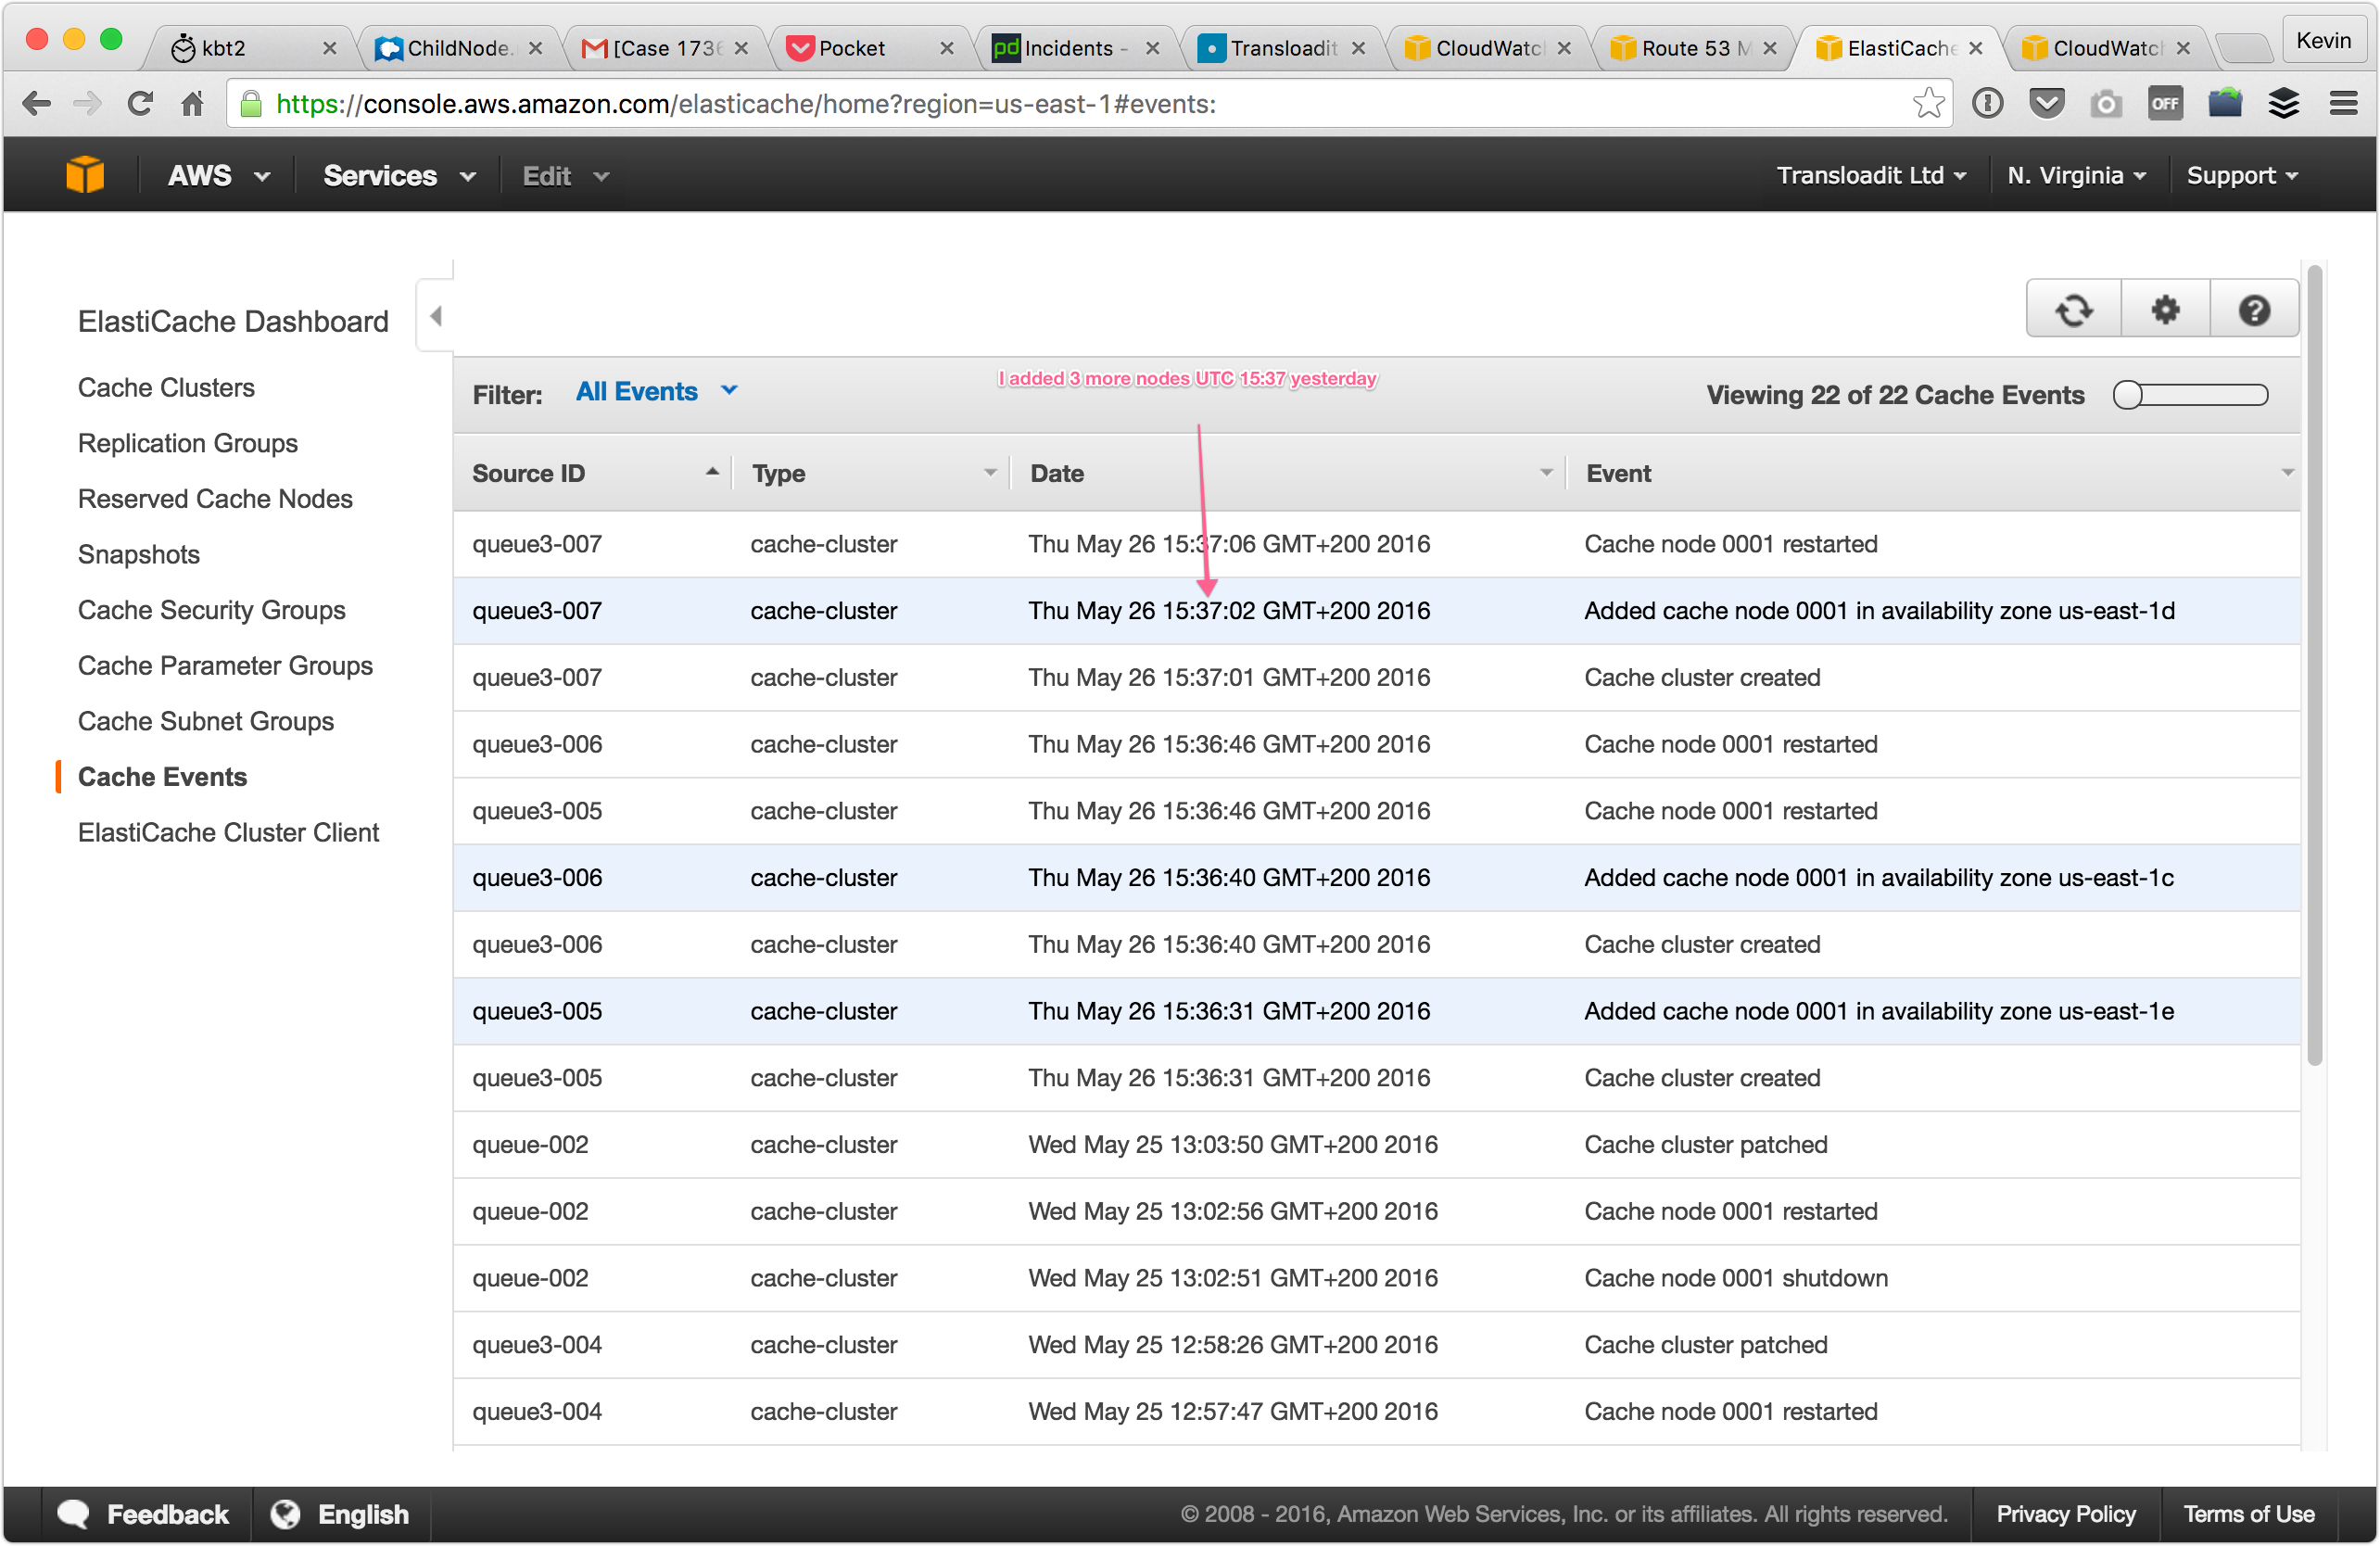
しかし、使用量はすぐに新たな飽和点に近づき、多くの Assemblyは依然として低速でした。当初は、必要なクラスター規模をまだ過小評価しているのだと考えました。3 台の Redis ノードの限界で制限されていたうえ、6 台でも足りないようだったため、さらに 3 台の Redis ノードを追加し、帯域幅の使用量への影響を見ることにしました。
ところが、驚いたことに、状況は悪化したようにしか見えませんでした。詳しく見ると、送信トラフィックの大半はクラスターのリーダーから発生していました。その量は約 4Gbit/s に達し、Amazon が公表する上限をはるかに超えていました(これは別のブログ記事で取り上げると面白いかもしれません)。一方、ほかの Redis ノードのトラフィックには十分な余裕がありました。
送信トラフィック(読み取り)はクラスター全体に分散されるはずなので、これは奇妙でした。なぜリーダーからこれほど大量のトラフィックが発生するのでしょうか。書き込みと Pub/Sub の処理を除けば、リーダーが送信するのは全体の約 9 分の 1 のはずです。
少ないほうが効果的
ここでようやく気づきました。レプリケーションです。すべての書き込みはリーダーに送られます。書き込んだデータの同期先は、以前は 2 台の Redis ノードでしたが、今や 8 台になっていました。Redis には gossip のような高度なプロトコルがないため、Drone が送信するすべてのデータを、2 台ではなく 8 台にコピーする必要が生じていたのです(2 台でもすでに問題がありました)。この Redis リーダー 1 台の処理量も、送信しなければならないトラフィックも 4 倍になっていました。
さらに厄介なことに、扱うデータは書き込みが多く、変化も激しいものでした。役立つのはごく短い間だけです。そのため、データをコピーしても、そのすぐ後にはまた削除しなければなりませんでした。
失われたデータは再追加できるため、一見よい方法に思えたレプリケーションが本当に必要なのか、改めて検討しました。
理想としては、レプリケーショントラフィックをゼロにして、空の Redis ノードにフェイルオーバーしたいところです。しかし、AWS Elasticache では自動フェイルオーバーにレプリケーションが必須です。今回分かったことを踏まえて、リードレプリカを 1 台に減らしました。すると、ログ上でトラフィックと失敗率がすぐに低下し、Assemblyの処理速度も再び上がり始めました。
ようやく一息
ついに根本原因が分かり、ようやく一息つけたところで、なぜこうなったのかを考え始めました。Redis の処理能力が突然飽和した理由を説明できるような変更は、コードにもインフラにも見つからず、不思議でした。
ただし、周辺環境では 2 つの変化が見つかりました。
- HLS トラフィックの急増。HLS は大きな動画を多数の小さな断片に分割し、モバイルユーザーがその時点の接続に最適な品質で、動画の次のチャンクをダウンロードできるようにします(接続が極端に悪くなると、最終的には音声のみになるまで段階的に品質を下げます)。このため、動画ごとにやり取りされるメタデータが 1000 倍にもなり得ます。
- 稼働中の Drone を増やすことで、同じ量をより短時間で処理できます。その分、中央のノードの負荷は必然的に高くなります
この 2 つの変化が重なり、インフラのボトルネックが表面化したのです。その後、問題を緩和しようと Redis ノード数を増やしましたが、これは判断ミスでした。実際には、マシンを増やすほどスループットに負担がかかっていたのです。より多くのトラフィックを処理するには、ノードを減らす必要がありました。
今後の対応
広範な調査を経て、前述のソフトウェアコンポーネントはすべてアップグレードしました。これにより、今回直面した帯域幅の問題とは別に、ハートビートやデータの消失につながり得る既知のバグの影響は受けなくなりました。また、再び飽和状態に近づいた場合に備えて、ログとアラームを追加しました。
Redis ノードと Drone、Uploader の間のトラフィックは正当なものでした。そのため、このトラフィックを分散する方法を検討し始める必要があります。レプリケーショントラフィックの削減で時間は稼げたかもしれませんが、書き込みを受け付ける Redis ノードが 1 台だけでは支えられない規模の成長にも対応したいと考えています。レプリケーションをなくして垂直スケーリング(1 台の Redis ノードをより大きくすること)をしても、次のボトルネックがすぐそこに迫ってしまいます。
リードレプリカのリードレプリカを設け、レプリケーショントラフィックを分散する案も検討しました。しかし、成長が続けば、それでも数か月ほどの猶予しか得られません。しかも、制約になっているのは書き込みであり、それを 1 台のマシンで処理し続ける必要がある以上、この案は選択肢から完全に外れます。
この用途に最適化された別の分散データストアへの移行も検討しましたが、これほど大規模な移行には、おそらく数か月とはいかなくても数週間はかかります。それだけの時間はありません。運用中のデータストアの入れ替えはただでさえ難しく、急いでいるとなればなおさらです。
現時点では、シャーディングが最善の選択肢に思えます。シャーディングでは、データを複数の論理グループに分割し、各グループを別々のハードウェアで実行できます(同じハードウェアでも実行でき、その配置は自分たちで決められます)。他社では、顧客ごとにシャーディングすることがよくあります。私たちはすでにリージョンごとにシャーディングしており、さらに Uploader ごとのシャーディングを追加する計画です。私たちの構成では、顧客ごとのシャーディングはあまり適していないように思えます。あるお客様の大規模なインポートだけで、Redis の処理能力を使い切る可能性があるためです。一方、トラフィックのピークに応じて Uploader はすでに増やしているので、トラフィックが増えるにつれて Redis の処理能力も増えていきます。トラフィックには Uploader 名のタグが付いているため、どの Redis ノードを対象にすべきかも明確になります。
この作業はすでに始まっており、今週中の導入を予定しています。それまでの間は、リージョンごとに Drone の増設数に上限を設けています。このため、大規模なバッチインポートの完了までに予想より少し時間がかかることがありますが、システムの安定性は維持されます。
お詫び
処理に時間がかかることも、自動で再実行されなかった Assemblyを手動で再実行しなければならないことも、大きなストレスになると承知しています。心よりお詫び申し上げるとともに、大きな影響を受けたお客様には 1 週間分のサービスを無料で提供したいと考えています。ご連絡いただければ、対応いたします。もちろん、求められているのは返金ではなく、信頼できるサービスであることも理解しています。それでも、この対応が少しでも負担を和らげ、こうした問題に真剣に取り組んでいる姿勢をお伝えする一助になれば幸いです。